Conteúdo
Como o Docker funciona por dentro: teste prático de namespaces, cgroups e overlayfs
O que é Docker explica os contêineres usando uma analogia. Nesta seção, vamos diretamente a um host Docker e ver o que um contêiner é no Linux. A resposta cabe em uma frase:
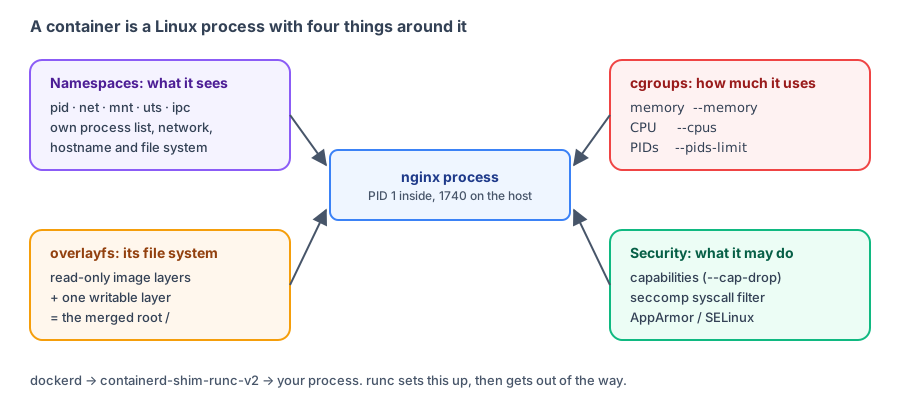
Um contêiner é um processo Linux comum, limitado por namespaces quanto ao que consegue "ver", por cgroups quanto aos recursos que pode usar, com um diretório montado por overlayfs como raiz e com o que pode fazer limitado por capabilities e seccomp.
Aqui, "host" é o ambiente Linux de teste do Docker usado neste tutorial (kernel Linux 5.4, cgroup v1). Ao executar no seu computador, os IDs, caminhos e outros valores serão diferentes. Em sistemas com cgroup v2, os nomes dos arquivos também mudam; isso será indicado ao longo do texto. Quem usa Docker Desktop pode executar
docker run -it --rm --privileged --pid=host alpine:3.23 nsenter -t 1 -m -u -i -n shpara entrar na máquina virtual Linux do Docker Desktop e observar.
Um contêiner é um processo no host
Inicie um contêiner nginx e limite a memória a 256 MB e a CPU a 0.5 núcleo:
$ docker run -d --name demo --memory 256m --cpus 0.5 nginx:1.30-alpine
WARNING: Your kernel does not support swap limit capabilities or the cgroup is not mounted. Memory limited without swap.
57dcd17505d4e7c71e57df55edef3e137c18249e6ad402c7e7b3f215341c47b4

$ docker exec demo ps
PID   USER     TIME  COMMAND
    1 root      0:00 nginx: master process nginx -g daemon off;
   29 nginx     0:00 nginx: worker process
   30 root      0:00 ps

$ docker inspect -f "{{.State.Pid}}" demo
12458- Dentro do contêiner, o PID do processo principal do nginx é 1, e ele só enxerga os próprios processos.
- O
.State.Piddedocker inspecté o PID dele no host: 12458.
Liste os processos no host:
$ ps -o pid,ppid,args | grep -v -E 'ps -o|grep|cut' | cut -c1-110
PID   PPID  COMMAND
    1     0 docker-init -- dockerd --host=unix:///var/run/docker.sock --host=tcp://0.0.0.0:2375 --registry-mir
   19     1 dockerd --host=unix:///var/run/docker.sock --host=tcp://0.0.0.0:2375 --registry-mirror=https://mir
12434     1 /usr/local/bin/containerd-shim-runc-v2 -namespace moby -id 57dcd17505d4e7c71e57df55edef3e137c18249
12458 12434 nginx: master process nginx -g daemon off;
12495 12458 nginx: worker process
No host, é possível ver a árvore completa de processos: dockerd → containerd-shim-runc-v2 → nginx: master process (12458) → nginx: worker process.
- containerd-shim-runc-v2: há um para cada contêiner; ele acompanha os processos do contêiner. Se o dockerd reiniciar, o contêiner não para junto com ele, graças a esse processo.
- runc: programa que realmente cria o contêiner. Depois de configurar os namespaces, cgroups e o diretório raiz, ele executa o nginx e termina. Por isso, não aparece na árvore de processos.
O mesmo processo tem PID 1 dentro do contêiner e PID 12458 no host. Esse é o efeito do namespace de PID.
namespace: determina o que o contêiner consegue ver
lsns lista os namespaces aos quais um processo pertence:
$ lsns -p 12458 -o NS,TYPE,PID,COMMAND
        NS TYPE     PID COMMAND
4026531835 cgroup     1 docker-init -- dockerd --host=unix:///var/run/docker.sock --host=tcp://0.0.0.0:2375 --registry-mirror=https://mirror.gcr.io --dns=1.1.1.1 --dns=8.8.8.8
4026531837 user       1 docker-init -- dockerd --host=unix:///var/run/docker.sock --host=tcp://0.0.0.0:2375 --registry-mirror=https://mirror.gcr.io --dns=1.1.1.1 --dns=8.8.8.8
4026533161 mnt    12458 nginx: master process nginx -g daemon off;
4026533162 uts    12458 nginx: master process nginx -g daemon off;
4026533163 ipc    12458 nginx: master process nginx -g daemon off;
4026533164 pid    12458 nginx: master process nginx -g daemon off;
4026533166 net    12458 nginx: master process nginx -g daemon off;
O processo nginx tem 5 namespaces próprios (com IDs diferentes dos do host), enquanto compartilha outros 2 (cgroup e user) com o PID 1 do host:
| namespace | O que é isolado | Efeito no contêiner |
|---|---|---|
pid | IDs de processo | Dentro do contêiner, você só vê os próprios processos; o processo principal é o PID 1 |
net | Interfaces de rede, IPs, portas e rotas | O contêiner tem seu próprio eth0 e IP, e pode escutar na porta 80 de forma independente |
mnt | Pontos de montagem | O contêiner tem seu próprio diretório raiz / |
uts | Nome do host | O hostname do contêiner é o ID do contêiner |
ipc | Memória compartilhada e semáforos | Os contêineres não podem interferir uns nos outros por meio de IPC |
user | Mapeamento de IDs de usuário | Por padrão, não é isolado: o root dentro do contêiner é o root do host; isso só é usado no modo Rootless |
cgroup | Visibilidade dos diretórios cgroup | Neste ambiente (cgroup v1), não há isolamento; sistemas com cgroup v2 isolam por padrão |
Efeitos dos namespaces uts e net:
$ docker exec demo hostname
57dcd17505d4

$ docker exec demo ip -4 addr show eth0
2: eth0@if130: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1500 qdisc noqueue state UP
    inet 172.18.0.2/16 brd 172.18.255.255 scope global eth0
       valid_lft forever preferred_lft forever
O nome do host do contêiner é formado pelos primeiros 12 caracteres do ID do contêiner. eth0 tem seu próprio IP (172.18.0.2), atribuído pela rede do Docker. Consulte Redes e comunicação entre contêineres para saber mais.
cgroup: determina quantos recursos o contêiner pode usar
--memory 256m --cpus 0.5 não é calculado pelo próprio Docker: esses valores são gravados na configuração de cgroup do kernel Linux. Leia essas configurações de dentro do contêiner:
$ docker info --format "Cgroup Version: {{.CgroupVersion}}"
Cgroup Version: 1

$ docker exec demo cat /sys/fs/cgroup/memory/memory.limit_in_bytes
268435456

$ docker exec demo cat /sys/fs/cgroup/memory/memory.usage_in_bytes
10842112

$ docker exec demo cat /sys/fs/cgroup/cpu/cpu.cfs_quota_us /sys/fs/cgroup/cpu/cpu.cfs_period_us
50000
100000

$ docker stats --no-stream --format "{{.Name}}  {{.MemUsage}}  {{.CPUPerc}}" demo
demo 5.613MiB / 256MiB 0.00%| Valor lido | Significado |
|---|---|
memory.limit_in_bytes = 268435456 | 268435456 bytes = 256 MiB, ou seja, --memory 256m |
memory.usage_in_bytes = 10842112 | Atualmente, cerca de 10 MB estão em uso (estatística do kernel, que inclui o cache de arquivos; por isso, o valor é maior que o exibido por docker stats) |
cpu.cfs_quota_us = 50000, cpu.cfs_period_us = 100000 | A cada 100 milissegundos, no máximo 50 milissegundos de tempo de CPU podem ser usados, ou seja, 0,5 núcleo |
O limite de 256MiB exibido por docker stats também é lido do cgroup. Quando a memória usada por um processo ultrapassa o limite, o kernel o encerra (OOM), com código de saída 137.
Em sistemas com cgroup v2 (versões recentes do Ubuntu, Debian e Fedora, além do Docker Desktop), os nomes dos arquivos são diferentes: o limite de memória fica em
/sys/fs/cgroup/memory.maxe a cota de CPU em/sys/fs/cgroup/cpu.max(o conteúdo é50000 100000).
overlayfs: o sistema de arquivos do contêiner
Camadas da imagem
Uma imagem é composta por várias camadas somente leitura:
$ docker image inspect -f "{{range .RootFS.Layers}}{{println .}}{{end}}" nginx:1.30-alpine
sha256:74d97c428c51a828f9051a7a40a53ff1fc99e54fc30323ce36760701b0b7f711
sha256:2d3fbe0ca19dd389108f7e9a1d89ec5c1f1d7dc3c11fb2123bc425fed39c5f22
sha256:ed752e851ebe79a0e72be1fd48e90474d36ae2bb2ddccff2475f8e050c20a804
sha256:ec2b9a359ab960e2254545e79e9bca77edaeefb652d97b26855217fb8a9c80b3
sha256:267e83adf4c4e342b08cbe40814662493e030c88311c720fbce2f0d7c809f3f4
sha256:8fb5da5ad6fa936ba8c24999da33095b2b6c5fd2bcf4aa22acbf299b0e7294df
sha256:0d250d8db7c20b3c0bd3059b3431dd47f130cb81e7a4c7820950139daafb91d6
sha256:e46f4042ccf5f36d1605617ef6912bdaac437fa0bca12530e77529b191eb02fa


$ docker history --format "{{.Size}}\t{{.CreatedBy}}" nginx:1.30-alpine | cut -c1-90
51.9MB	RUN /bin/sh -c set -x     && apkArch="$(cat …
0B	ENV ACME_VERSION=0.4.1
0B	ENV NJS_RELEASE=1
0B	ENV NJS_VERSION=1.0.1
0B	CMD ["nginx" "-g" "daemon off;"]
0B	STOPSIGNAL SIGQUIT
0B	EXPOSE map[80/tcp:{}]
0B	ENTRYPOINT ["/docker-entrypoint.sh"]
16.4kB	COPY 30-tune-worker-processes.sh /docker-ent…
12.3kB	COPY 20-envsubst-on-templates.sh /docker-ent…
12.3kB	COPY 15-local-resolvers.envsh /docker-entryp…
12.3kB	COPY 10-listen-on-ipv6-by-default.sh /docker…
8.19kB	COPY docker-entrypoint.sh / # buildkit
5.62MB	RUN /bin/sh -c set -x     && addgroup -g 101…
0B	ENV DYNPKG_RELEASE=1
0B	ENV PKG_RELEASE=1
0B	ENV NGINX_VERSION=1.30.5
0B	LABEL maintainer=NGINX Docker Maintainers <d…
0B	CMD ["/bin/sh"]
9.08MB ADD alpine-minirootfs-3.24.2-x86_64.tar.gz /…RootFS.Layerslista os hashes das 8 camadas.docker historymostra qual linha do Dockerfile criou cada camada. As entradas de tamanho0B(ENV,CMD,EXPOSE) alteraram apenas a configuração e não geraram arquivos, por isso não têm uma camada correspondente. A entradaADD alpine-minirootfs...na parte inferior é a imagem base do Alpine.
Camadas sobrepostas que formam o diretório raiz
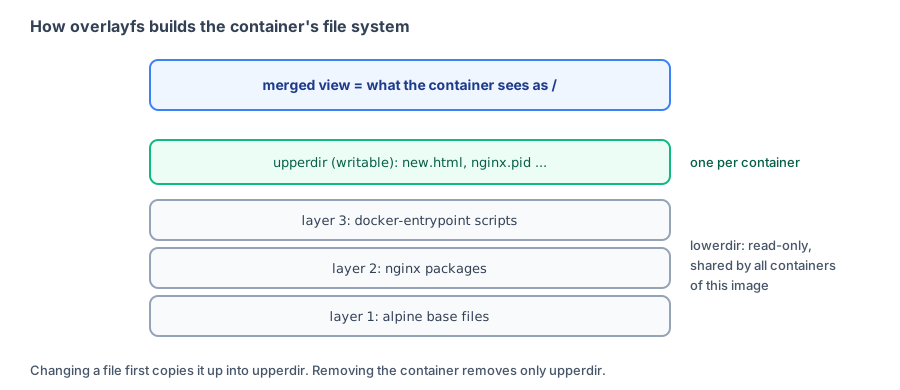
Quando o contêiner é iniciado, o Docker usa o overlayfs para sobrepor essas camadas e adicionar uma camada gravável. Veja as informações de montagem desse contêiner no host:
$ grep overlay /proc/mounts | grep $(docker inspect -f '{{.Id}}' demo) | tr ',' '\n' | sed 's#/var/lib/docker/containerd/daemon/io.containerd.snapshotter.v1.overlayfs/snapshots#…/snapshots#g'
overlay /var/lib/docker/rootfs/overlayfs/57dcd17505d4e7c71e57df55edef3e137c18249e6ad402c7e7b3f215341c47b4 overlay rw
relatime
lowerdir=…/snapshots/260/fs:…/snapshots/21/fs:…/snapshots/20/fs:…/snapshots/19/fs:…/snapshots/18/fs:…/snapshots/17/fs:…/snapshots/16/fs:…/snapshots/15/fs:…/snapshots/1/fs
upperdir=…/snapshots/261/fs
workdir=…/snapshots/261/work
xino=off 0 0
(O caminho é muito longo, então … substitui /var/lib/docker/containerd/daemon/io.containerd.snapshotter.v1.overlayfs.)
| Item | Significado |
|---|---|
lowerdir | Camadas de imagem somente leitura, sobrepostas de cima para baixo; compartilhadas por todos os contêineres que usam essa imagem |
upperdir | Camada gravável exclusiva deste contêiner |
workdir | Diretório temporário usado internamente pelo overlayfs |
Ponto de montagem /var/lib/docker/rootfs/overlayfs/ID do contêiner | Resultado combinado, que é o / visto pelo contêiner |
Onde vão os arquivos gravados pelo contêiner
Crie um arquivo dentro do contêiner e procure-o no upperdir do host:
$ docker exec demo sh -c "echo hello > /usr/share/nginx/html/new.html"

$ find /var/lib/docker/containerd/daemon/io.containerd.snapshotter.v1.overlayfs/snapshots/261/fs -type f | sed 's#.*/fs/#upperdir/#'
upperdir/usr/share/nginx/html/new.html
upperdir/run/nginx.pid
upperdir/etc/nginx/conf.d/default.conf

$ docker diff demo
C /etc
C /etc/nginx
C /etc/nginx/conf.d
C /etc/nginx/conf.d/default.conf
C /usr
C /usr/share
C /usr/share/nginx
C /usr/share/nginx/html
A /usr/share/nginx/html/new.html
C /run
A /run/nginx.pid
C /var
C /var/cache
C /var/cache/nginx
A /var/cache/nginx/client_temp
A /var/cache/nginx/fastcgi_temp
A /var/cache/nginx/proxy_temp
A /var/cache/nginx/scgi_temp
A /var/cache/nginx/uwsgi_temp- O arquivo novo
new.htmlaparece no upperdir. nginx.pidé gravado quando o nginx é iniciado;default.conffoi modificado pelo script de inicialização da imagem (que adiciona a configuração de IPv6). Quando um arquivo existente na imagem é modificado, o overlayfs primeiro o copia para o upperdir e depois o modifica (copy-up).docker difflista o conteúdo do upperdir:Aindica adição,Cindica alteração (incluindo diretórios pai) eDindica exclusão.
Portanto:
- Excluir o contêiner = excluir o upperdir dele; os dados gravados no contêiner desaparecem. Por isso os dados devem ficar em um volume, um diretório montado diretamente, sem passar pelo overlayfs.
- Se uma imagem iniciar 100 contêineres, as camadas da imagem são armazenadas uma única vez.
- No Dockerfile, fazer "primeiro COPY, depois RUN rm" não reduz o tamanho da imagem, porque o arquivo continua na camada somente leitura abaixo. As práticas recomendadas de segurança também abordam esse ponto.
capabilities e seccomp: determinam o que o contêiner pode fazer
$ docker info --format "{{.Driver}} {{json .SecurityOptions}}"
overlayfs ["name=apparmor,profile=default","name=seccomp,profile=builtin"]

$ docker exec demo grep CapEff /proc/1/status
CapEff:	00000000a80425fb

$ docker run --rm --cap-drop ALL alpine:3.23 grep CapEff /proc/1/status
CapEff:	0000000000000000
docker infomostra que este ambiente ativou as configurações padrão do AppArmor e do seccomp. O seccomp bloqueia algumas chamadas de sistema perigosas feitas pelo contêiner (como carregar módulos do kernel).CapEffsão as capabilities que o processo possui atualmente (representadas em bits). Por padrão, o root dentro do contêiner tem apenas parte das permissões (a80425fb), e não acesso root completo; depois de--cap-drop ALL, todas ficam zeradas. Consulte o efeito real nas práticas recomendadas de segurança.--privilegedconcede ao contêiner todas as capabilities e desativa seccomp e AppArmor, removendo essa camada de proteção.
Comparação com máquinas virtuais
| Contêiner | Máquina virtual | |
|---|---|---|
| Kernel | Compartilha o kernel Linux do host | Cada máquina virtual tem seu próprio kernel |
| Isolamento | Recursos do kernel, como namespace, cgroup e seccomp | Virtualização de hardware |
| Inicialização | Inicia um processo, geralmente em menos de 1 segundo | Inicializa o sistema, de alguns a dezenas de segundos |
| Sobrecarga adicional | Quase nenhuma | É preciso alocar memória e CPU para cada máquina virtual |
| Nível de isolamento | Menor; uma vulnerabilidade no kernel pode afetar todos os contêineres | Maior |
Isso também explica alguns comportamentos comuns:
- Em um host Linux,
psmostra os processos do contêiner; no Windows e no macOS, não, porque os contêineres ficam na máquina virtual do Docker Desktop. - O contêiner não pode executar um sistema operacional com um kernel diferente. Por exemplo, um host Linux não pode executar diretamente contêineres Windows.
- O erro
exec format errorem imagens multiplataforma: o contêiner não tem CPU própria, então o programa precisa estar em um formato que a CPU do host consiga executar.
Resumo
- Um contêiner é um processo Linux no host, criado pelo runc e supervisionado pelo containerd-shim.
- O namespace isola processos, rede, montagens, nome do host e outros “itens visíveis”; por padrão, não isola usuários.
- O cgroup implementa
--memory,--cpuse--pids-limit; os valores configurados podem ser lidos diretamente nos arquivos do cgroup. - O overlayfs combina as camadas de imagem somente leitura com um upperdir gravável para formar o diretório raiz do contêiner; excluir o contêiner também exclui o upperdir.
- capabilities, seccomp e AppArmor limitam o que o root dentro do contêiner pode fazer.
--privilegedremove todas essas proteções.
Exercícios
Exercício 1: execute docker run -d --name t1 --pids-limit 50 alpine:3.23 sleep 600 e, em seguida, leia o limite de PID de dentro do contêiner.
Resposta
cgroup v1:
docker exec t1 cat /sys/fs/cgroup/pids/pids.maxcgroup v2:
docker exec t1 cat /sys/fs/cgroup/pids.maxAmbos devem exibir 50. Use docker info --format "{{.CgroupVersion}}" para confirmar qual versão seu sistema usa.
Exercício 2: exclua de dentro do contêiner um arquivo que já existia na imagem (por exemplo, docker exec t1 rm /etc/motd) e depois execute docker diff t1. O que você verá? O arquivo da imagem foi realmente excluído?
Resposta
docker diff exibirá D /etc/motd. As camadas da imagem são somente leitura, então o arquivo não foi realmente excluído: o overlayfs colocou um "marcador de exclusão" (whiteout) no upperdir para que ele não apareça na visualização combinada. Inicie um novo contêiner usando a mesma imagem, e /etc/motd ainda estará lá.
Exercício 3: inicie dois contêineres nginx:1.30-alpine ao mesmo tempo e compare seus lowerdir e upperdir.
Dica
Execute grep overlay /proc/mounts no host Linux. O lowerdir dos dois contêineres é exatamente igual (eles compartilham as camadas da imagem), enquanto cada um tem seu próprio upperdir.
Perguntas frequentes
Qual é a diferença fundamental entre contêineres e máquinas virtuais?
Uma máquina virtual simula um computador inteiro, com seu próprio kernel de sistema operacional; um contêiner não tem kernel próprio. Todos os contêineres usam diretamente o kernel Linux do host, separados por namespaces e cgroups. Por isso, iniciar um contêiner requer apenas iniciar um processo e leva muito pouco tempo.
Por que Windows e macOS também conseguem executar contêineres Linux?
Porque o Docker Desktop inicia nos bastidores uma pequena máquina virtual Linux (no Windows, o WSL 2). Na prática, os contêineres são executados no kernel Linux dessa máquina virtual.
Qual é a diferença entre cgroup v1 e v2?
Ambos são mecanismos do kernel Linux para limitar recursos. O v2 é a versão mais nova e unifica a estrutura de diretórios. Os nomes dos arquivos diferem: por exemplo, o limite de memória é memory.limit_in_bytes no v1 e memory.max no v2; a cota de CPU é cpu.max no v2. Distribuições recentes e o Docker Desktop usam v2 por padrão. docker info mostra isso em Cgroup Version.
Uma imagem que inicia 100 contêineres ocupa 100 vezes mais espaço?
Não. As camadas da imagem são somente leitura (lowerdir) e compartilhadas por todos os contêineres. Cada contêiner acrescenta apenas seu próprio upperdir, onde ficam os arquivos que ele grava ou modifica.
Atualizado 14 de outubro de 2026