目錄
Docker 底層原理:namespace、cgroup 與 overlayfs 實測
Docker 是什麼 用比喻說明了容器;這一節直接到 Docker 主機上看:容器在 Linux 中到底是什麼。答案只有一句話:
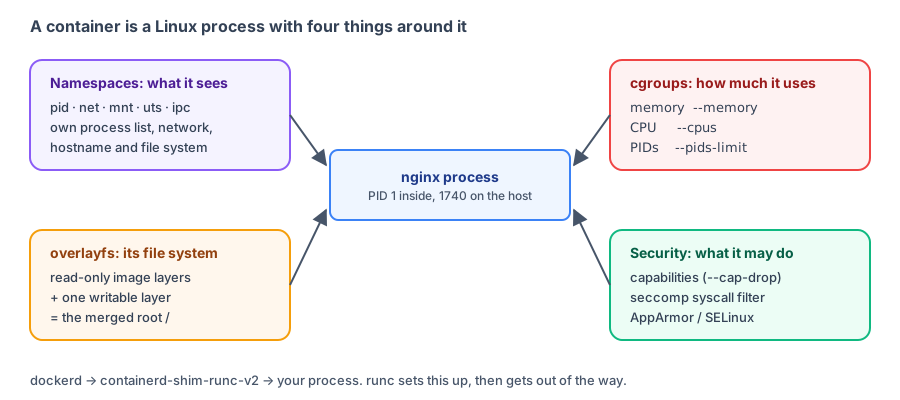
容器就是一個普通的 Linux 程序,只是被 namespace 限制了「看得到什麼」、被 cgroup 限制了「能用多少」、用 overlayfs 組成的目錄當作它的根目錄,再由 capabilities 和 seccomp 限制「能做什麼」。
以下的「主機」是本教學的 Docker 測試環境(Linux 5.4 核心、cgroup v1)。在你的電腦上執行時,ID、路徑等數值會不同;使用 cgroup v2 的系統,檔案名稱也不同,文中會註明。Docker Desktop 的使用者可以用
docker run -it --rm --privileged --pid=host alpine:3.23 nsenter -t 1 -m -u -i -n sh進入 Docker Desktop 的 Linux 虛擬機觀察。
容器就是主機上的一個程序
啟動一個 nginx 容器,同時限制記憶體 256 MB、CPU 0.5 核:
$ docker run -d --name demo --memory 256m --cpus 0.5 nginx:1.30-alpine
WARNING: Your kernel does not support swap limit capabilities or the cgroup is not mounted. Memory limited without swap.
57dcd17505d4e7c71e57df55edef3e137c18249e6ad402c7e7b3f215341c47b4

$ docker exec demo ps
PID   USER     TIME  COMMAND
    1 root      0:00 nginx: master process nginx -g daemon off;
   29 nginx     0:00 nginx: worker process
   30 root      0:00 ps

$ docker inspect -f "{{.State.Pid}}" demo
12458- 在容器裡,nginx 主程序的 PID 是 1,而且只看得到自己的程序。
docker inspect的.State.Pid是它在主機上的 PID:12458。
在主機上列出程序:
$ ps -o pid,ppid,args | grep -v -E 'ps -o|grep|cut' | cut -c1-110
PID   PPID  COMMAND
    1     0 docker-init -- dockerd --host=unix:///var/run/docker.sock --host=tcp://0.0.0.0:2375 --registry-mir
   19     1 dockerd --host=unix:///var/run/docker.sock --host=tcp://0.0.0.0:2375 --registry-mirror=https://mir
12434     1 /usr/local/bin/containerd-shim-runc-v2 -namespace moby -id 57dcd17505d4e7c71e57df55edef3e137c18249
12458 12434 nginx: master process nginx -g daemon off;
12495 12458 nginx: worker process主機上看得到完整的程序樹:dockerd → containerd-shim-runc-v2 → nginx: master process(12458)→ nginx: worker process。
- containerd-shim-runc-v2:每個容器一個,負責看管容器的程序。dockerd 重啟時容器不會跟著停止,就是因為有它。
- runc:真正建立容器的程式。它設定好 namespace、cgroup、根目錄後,就執行 nginx 並結束,所以在程序樹中看不到它。
同一個程序,在容器內是 PID 1、在主機上是 PID 12458,這就是 PID namespace 的效果。
namespace:決定容器看得到什麼
lsns 列出一個程序所在的 namespace:
$ lsns -p 12458 -o NS,TYPE,PID,COMMAND
        NS TYPE     PID COMMAND
4026531835 cgroup     1 docker-init -- dockerd --host=unix:///var/run/docker.sock --host=tcp://0.0.0.0:2375 --registry-mirror=https://mirror.gcr.io --dns=1.1.1.1 --dns=8.8.8.8
4026531837 user       1 docker-init -- dockerd --host=unix:///var/run/docker.sock --host=tcp://0.0.0.0:2375 --registry-mirror=https://mirror.gcr.io --dns=1.1.1.1 --dns=8.8.8.8
4026533161 mnt    12458 nginx: master process nginx -g daemon off;
4026533162 uts    12458 nginx: master process nginx -g daemon off;
4026533163 ipc    12458 nginx: master process nginx -g daemon off;
4026533164 pid    12458 nginx: master process nginx -g daemon off;
4026533166 net    12458 nginx: master process nginx -g daemon off;
nginx 程序有自己的 5 個 namespace(ID 和主機的不同),另外 2 個(cgroup、user)與主機上的 PID 1 共用:
| namespace | 隔離的東西 | 容器中的效果 |
|---|---|---|
pid | 程序編號 | 容器內只看得到自己的程序,主程序是 PID 1 |
net | 網路介面、IP、連接埠、路由 | 容器有自己的 eth0 和 IP,可以各自監聽 80 埠 |
mnt | 掛載點 | 容器有自己的根目錄 / |
uts | 主機名稱 | 容器的 hostname 是容器 ID |
ipc | 共用記憶體、訊號量 | 容器之間不能用 IPC 互相干擾 |
user | 使用者 ID 對應 | 預設不隔離,容器內的 root 就是主機的 root;Rootless 模式 才會使用 |
cgroup | cgroup 目錄的視野 | 這個環境(cgroup v1)沒有隔離;cgroup v2 的系統預設會隔離 |
uts 與 net namespace 的效果:
$ docker exec demo hostname
57dcd17505d4

$ docker exec demo ip -4 addr show eth0
2: eth0@if130: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1500 qdisc noqueue state UP
    inet 172.18.0.2/16 brd 172.18.255.255 scope global eth0
       valid_lft forever preferred_lft forever
容器的主機名稱就是容器 ID 的前 12 碼,eth0 有自己的 IP(172.18.0.2),這是 Docker 網路分配的,詳見 網路與容器互連。
cgroup:決定容器能用多少資源
--memory 256m --cpus 0.5 不是 Docker 自己計算的,而是寫進 Linux 核心的 cgroup 設定。從容器內讀出這些設定:
$ docker info --format "Cgroup Version: {{.CgroupVersion}}"
Cgroup Version: 1

$ docker exec demo cat /sys/fs/cgroup/memory/memory.limit_in_bytes
268435456

$ docker exec demo cat /sys/fs/cgroup/memory/memory.usage_in_bytes
10842112

$ docker exec demo cat /sys/fs/cgroup/cpu/cpu.cfs_quota_us /sys/fs/cgroup/cpu/cpu.cfs_period_us
50000
100000

$ docker stats --no-stream --format "{{.Name}}  {{.MemUsage}}  {{.CPUPerc}}" demo
demo 5.613MiB / 256MiB 0.00%| 讀到的值 | 意思 |
|---|---|
memory.limit_in_bytes = 268435456 | 268435456 bytes = 256 MiB,就是 --memory 256m |
memory.usage_in_bytes = 10842112 | 目前約用了 10 MB(核心統計,包含檔案快取,所以比 docker stats 顯示的大) |
cpu.cfs_quota_us = 50000、cpu.cfs_period_us = 100000 | 每 100 毫秒最多使用 50 毫秒的 CPU 時間,也就是 0.5 核 |
docker stats 顯示的 256MiB 上限也是從 cgroup 讀出來的。程序使用的記憶體超過上限時,核心會把它終止(OOM),結束代碼是 137。
cgroup v2 的系統(近年的 Ubuntu、Debian、Fedora,以及 Docker Desktop)檔案名稱不同:記憶體上限在
/sys/fs/cgroup/memory.max,CPU 配額在/sys/fs/cgroup/cpu.max(內容是50000 100000)。
overlayfs:容器的檔案系統
映像檔的層
映像檔由多個唯讀的層組成:
$ docker image inspect -f "{{range .RootFS.Layers}}{{println .}}{{end}}" nginx:1.30-alpine
sha256:74d97c428c51a828f9051a7a40a53ff1fc99e54fc30323ce36760701b0b7f711
sha256:2d3fbe0ca19dd389108f7e9a1d89ec5c1f1d7dc3c11fb2123bc425fed39c5f22
sha256:ed752e851ebe79a0e72be1fd48e90474d36ae2bb2ddccff2475f8e050c20a804
sha256:ec2b9a359ab960e2254545e79e9bca77edaeefb652d97b26855217fb8a9c80b3
sha256:267e83adf4c4e342b08cbe40814662493e030c88311c720fbce2f0d7c809f3f4
sha256:8fb5da5ad6fa936ba8c24999da33095b2b6c5fd2bcf4aa22acbf299b0e7294df
sha256:0d250d8db7c20b3c0bd3059b3431dd47f130cb81e7a4c7820950139daafb91d6
sha256:e46f4042ccf5f36d1605617ef6912bdaac437fa0bca12530e77529b191eb02fa


$ docker history --format "{{.Size}}\t{{.CreatedBy}}" nginx:1.30-alpine | cut -c1-90
51.9MB	RUN /bin/sh -c set -x     && apkArch="$(cat …
0B	ENV ACME_VERSION=0.4.1
0B	ENV NJS_RELEASE=1
0B	ENV NJS_VERSION=1.0.1
0B	CMD ["nginx" "-g" "daemon off;"]
0B	STOPSIGNAL SIGQUIT
0B	EXPOSE map[80/tcp:{}]
0B	ENTRYPOINT ["/docker-entrypoint.sh"]
16.4kB	COPY 30-tune-worker-processes.sh /docker-ent…
12.3kB	COPY 20-envsubst-on-templates.sh /docker-ent…
12.3kB	COPY 15-local-resolvers.envsh /docker-entryp…
12.3kB	COPY 10-listen-on-ipv6-by-default.sh /docker…
8.19kB	COPY docker-entrypoint.sh / # buildkit
5.62MB	RUN /bin/sh -c set -x     && addgroup -g 101…
0B	ENV DYNPKG_RELEASE=1
0B	ENV PKG_RELEASE=1
0B	ENV NGINX_VERSION=1.30.5
0B	LABEL maintainer=NGINX Docker Maintainers <d…
0B	CMD ["/bin/sh"]
9.08MB ADD alpine-minirootfs-3.24.2-x86_64.tar.gz /…RootFS.Layers列出 8 個層的雜湊值。docker history列出每一層是由 Dockerfile 的哪一行建立的。大小為0B的(ENV、CMD、EXPOSE)只改了設定,沒有產生檔案,所以沒有對應的層。最底下的ADD alpine-minirootfs...就是 Alpine 基礎映像檔。
疊起來成為根目錄
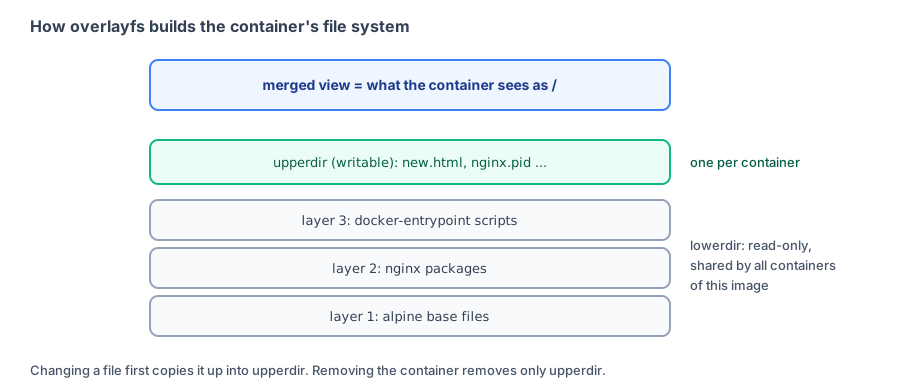
容器啟動時,Docker 用 overlayfs 把這些層疊在一起,再加上一個可寫的層。在主機上查看這個容器的掛載資訊:
$ grep overlay /proc/mounts | grep $(docker inspect -f '{{.Id}}' demo) | tr ',' '\n' | sed 's#/var/lib/docker/containerd/daemon/io.containerd.snapshotter.v1.overlayfs/snapshots#…/snapshots#g'
overlay /var/lib/docker/rootfs/overlayfs/57dcd17505d4e7c71e57df55edef3e137c18249e6ad402c7e7b3f215341c47b4 overlay rw
relatime
lowerdir=…/snapshots/260/fs:…/snapshots/21/fs:…/snapshots/20/fs:…/snapshots/19/fs:…/snapshots/18/fs:…/snapshots/17/fs:…/snapshots/16/fs:…/snapshots/15/fs:…/snapshots/1/fs
upperdir=…/snapshots/261/fs
workdir=…/snapshots/261/work
xino=off 0 0
(路徑太長,用 … 代替了 /var/lib/docker/containerd/daemon/io.containerd.snapshotter.v1.overlayfs。)
| 項目 | 意思 |
|---|---|
lowerdir | 唯讀的映像檔層,由上到下疊加,所有使用這個映像檔的容器共用 |
upperdir | 這個容器專屬的可寫層 |
workdir | overlayfs 內部使用的暫存目錄 |
掛載點 /var/lib/docker/rootfs/overlayfs/容器ID | 合併後的結果,就是容器看到的 / |
容器寫入的檔案去了哪裡
在容器內建立一個檔案,然後到主機上的 upperdir 找它:
$ docker exec demo sh -c "echo hello > /usr/share/nginx/html/new.html"

$ find /var/lib/docker/containerd/daemon/io.containerd.snapshotter.v1.overlayfs/snapshots/261/fs -type f | sed 's#.*/fs/#upperdir/#'
upperdir/usr/share/nginx/html/new.html
upperdir/run/nginx.pid
upperdir/etc/nginx/conf.d/default.conf

$ docker diff demo
C /etc
C /etc/nginx
C /etc/nginx/conf.d
C /etc/nginx/conf.d/default.conf
C /usr
C /usr/share
C /usr/share/nginx
C /usr/share/nginx/html
A /usr/share/nginx/html/new.html
C /run
A /run/nginx.pid
C /var
C /var/cache
C /var/cache/nginx
A /var/cache/nginx/client_temp
A /var/cache/nginx/fastcgi_temp
A /var/cache/nginx/proxy_temp
A /var/cache/nginx/scgi_temp
A /var/cache/nginx/uwsgi_temp- 新增的
new.html出現在 upperdir 中。 nginx.pid是 nginx 啟動時寫的;default.conf被映像檔的啟動腳本修改過(加上 IPv6 設定),修改映像檔中已有的檔案時,overlayfs 會先把它複製到 upperdir 再修改(copy-up)。docker diff就是列出 upperdir 的內容:A是新增、C是變更(含上層資料夾)、D是刪除。
所以:
- 刪除容器 = 刪除它的 upperdir,容器內寫入的資料就消失了。這就是為什麼資料要放在 Volume,Volume 是直接掛載的目錄,不經過 overlayfs。
- 一個映像檔啟動 100 個容器,映像檔的層只存一份。
- 在 Dockerfile 中「先 COPY 再 RUN rm」不會讓映像檔變小,因為檔案還在下面的唯讀層中,安全最佳實務 甚至把它取了出來。
capabilities 與 seccomp:決定容器能做什麼
$ docker info --format "{{.Driver}} {{json .SecurityOptions}}"
overlayfs ["name=apparmor,profile=default","name=seccomp,profile=builtin"]

$ docker exec demo grep CapEff /proc/1/status
CapEff:	00000000a80425fb

$ docker run --rm --cap-drop ALL alpine:3.23 grep CapEff /proc/1/status
CapEff:	0000000000000000
docker info顯示這個環境啟用了 AppArmor 和 seccomp 的預設設定。seccomp 會阻擋容器呼叫一部分危險的系統呼叫(例如載入核心模組)。CapEff是程序目前擁有的 capabilities(以位元表示)。容器內的 root 預設只有一部分權限(a80425fb),不是完整的 root;--cap-drop ALL後全部歸零。實際效果見 安全最佳實務。--privileged會給容器所有 capabilities、關掉 seccomp 和 AppArmor,等於拿掉這一層保護。
和虛擬機的比較
| 容器 | 虛擬機 | |
|---|---|---|
| 核心 | 共用主機的 Linux 核心 | 每台虛擬機有自己的核心 |
| 隔離方式 | namespace、cgroup、seccomp 等核心功能 | 硬體虛擬化 |
| 啟動 | 啟動一個程序,通常不到 1 秒 | 開機,數秒到數十秒 |
| 額外負擔 | 幾乎沒有 | 需要為每台虛擬機分配記憶體與 CPU |
| 隔離強度 | 較弱,核心漏洞可能影響所有容器 | 較強 |
這也解釋了幾個常見現象:
- Linux 主機上
ps看得到容器的程序;Windows 和 macOS 看不到,因為容器在 Docker Desktop 的虛擬機裡。 - 容器不能執行不同核心的作業系統,例如 Linux 主機不能直接執行 Windows 容器。
- 多平台映像檔 的
exec format error:容器沒有自己的 CPU,程式必須是主機 CPU 能執行的格式。
重點回顧
- 容器是主機上的一個 Linux 程序,由 runc 建立、containerd-shim 看管。
- namespace 隔離程序、網路、掛載、主機名稱等「看得到的東西」;預設不隔離使用者。
- cgroup 實作
--memory、--cpus、--pids-limit,設定值可以直接在 cgroup 檔案中讀到。 - overlayfs 把唯讀的映像檔層加上一個可寫的 upperdir,合併成容器的根目錄;刪除容器就刪除 upperdir。
- capabilities、seccomp、AppArmor 限制容器內 root 能做的事,
--privileged會全部拿掉。
動手練習
練習 1:執行 docker run -d --name t1 --pids-limit 50 alpine:3.23 sleep 600,然後從容器內讀出 PID 上限。
答案
cgroup v1:
docker exec t1 cat /sys/fs/cgroup/pids/pids.maxcgroup v2:
docker exec t1 cat /sys/fs/cgroup/pids.max兩者都應該顯示 50。用 docker info --format "{{.CgroupVersion}}" 確認你的系統是哪一版。
練習 2:在容器內刪除映像檔中原有的檔案(例如 docker exec t1 rm /etc/motd),再執行 docker diff t1,會看到什麼?映像檔中的檔案真的被刪除了嗎?
答案
docker diff 會顯示 D /etc/motd。映像檔的層是唯讀的,檔案並沒有真的被刪除:overlayfs 在 upperdir 中放了一個「刪除標記」(whiteout),讓合併後的檢視看不到它。用同一個映像檔啟動新容器,/etc/motd 仍然存在。
練習 3:同時啟動兩個 nginx:1.30-alpine 容器,比較它們的 lowerdir 和 upperdir。
提示
在 Linux 主機上執行 grep overlay /proc/mounts。兩個容器的 lowerdir 完全相同(共用映像檔的層),upperdir 則各自不同。
常見問題
容器和虛擬機最根本的差別是什麼?
虛擬機模擬了一整台電腦,裡面跑著自己的作業系統核心;容器沒有自己的核心,所有容器都直接使用主機的 Linux 核心,只是被 namespace 和 cgroup 隔開。所以容器啟動只需要啟動一個程序,幾乎不花時間。
為什麼 Windows 和 macOS 也能執行 Linux 容器?
因為 Docker Desktop 在背後啟動了一個小型的 Linux 虛擬機(Windows 上是 WSL 2),容器實際上是在那個虛擬機的 Linux 核心上執行。
cgroup v1 和 v2 有什麼差別?
兩者都是 Linux 核心限制資源的機制,v2 是新版、目錄結構統一。檔案名稱不同,例如記憶體上限在 v1 是 memory.limit_in_bytes,在 v2 是 memory.max;CPU 配額在 v2 是 cpu.max。近年的發行版與 Docker Desktop 預設都是 v2,docker info 的 Cgroup Version 會顯示。
一個映像檔啟動 100 個容器,會佔用 100 倍的空間嗎?
不會。映像檔的層是唯讀的 lowerdir,所有容器共用;每個容器只多一個自己的 upperdir,存放它寫入或修改的檔案。
更新於 2026年10月14日