目錄
n8n 串接 Ollama:用本機免費模型打造 AI 自動化
使用 OpenAI 等雲端模型需要按用量付費,資料也會傳到外部。搭配 Ollama,可以讓 n8n 使用在自己電腦或伺服器上執行的開源模型:
- 不需要 API 費用
- 資料完全不離開你的環境
- 適合大量、重複的處理(分類、摘要、擷取資料)
還不熟悉 Ollama 的話,可以先看 Ollama 教學。
準備 Ollama 與模型
ollama pull qwen3:8b        # 聊天模型,中文能力好、支援工具呼叫
ollama pull bge-m3          # 嵌入模型,RAG 用
AI Agent 需要支援工具呼叫的模型(在 ollama.com 上標示 tools)。
最重要的一步:連線網址
n8n 要能連到 Ollama 的 API(預設連接埠 11434)。網址取決於兩者怎麼安裝:
| n8n | Ollama | Base URL |
|---|---|---|
| 直接安裝(npx) | 同一台電腦直接安裝 | http://localhost:11434 |
| Docker | 主機上直接安裝(Windows / macOS) | http://host.docker.internal:11434 |
| Docker | 主機上直接安裝(Linux) | http://host.docker.internal:11434,並在 n8n 容器加上 --add-host=host.docker.internal:host-gateway |
| Docker Compose | 同一個 Compose 中的 ollama 服務 | http://ollama:11434 |
| 任意 | 另一台電腦 | http://那台電腦的IP:11434 |
n8n 在 Docker 容器中時,
localhost指的是容器自己,不是你的電腦。這是最常見的連線失敗原因。
Linux 主機上的 Ollama 預設只監聽 127.0.0.1,Docker 容器可能連不到。需要把 OLLAMA_HOST 設為 0.0.0.0(並用防火牆阻擋外部連線),設定方法見 Ollama 環境變數。
推薦:用 Compose 一起部署
services:
  n8n:
    image: n8nio/n8n
    ports:
      - "5678:5678"
    environment:
      GENERIC_TIMEZONE: Asia/Taipei
      TZ: Asia/Taipei
    volumes:
      - n8n_data:/home/node/.n8n
    restart: unless-stopped

  ollama:
    image: ollama/ollama
    volumes:
      - ollama:/root/.ollama
    restart: unless-stopped
    # 有 NVIDIA 顯示卡時加上:
    # deploy:
    #   resources:
    #     reservations:
    #       devices:
    #         - driver: nvidia
    #           count: all
    #           capabilities: [gpu]

volumes:
  n8n_data:
  ollama:
docker compose up -d
docker compose exec ollama ollama pull qwen3:8bn8n 中的 Base URL 填 http://ollama:11434。
建立 Ollama 憑證
- 在 AI Agent 的 Chat Model 插槽選擇 Ollama Chat Model。
- 建立新的 Ollama 憑證,Base URL 依上表填寫。
- 儲存時 n8n 會測試連線,成功後在 Model 下拉選單中可以看到已下載的模型。
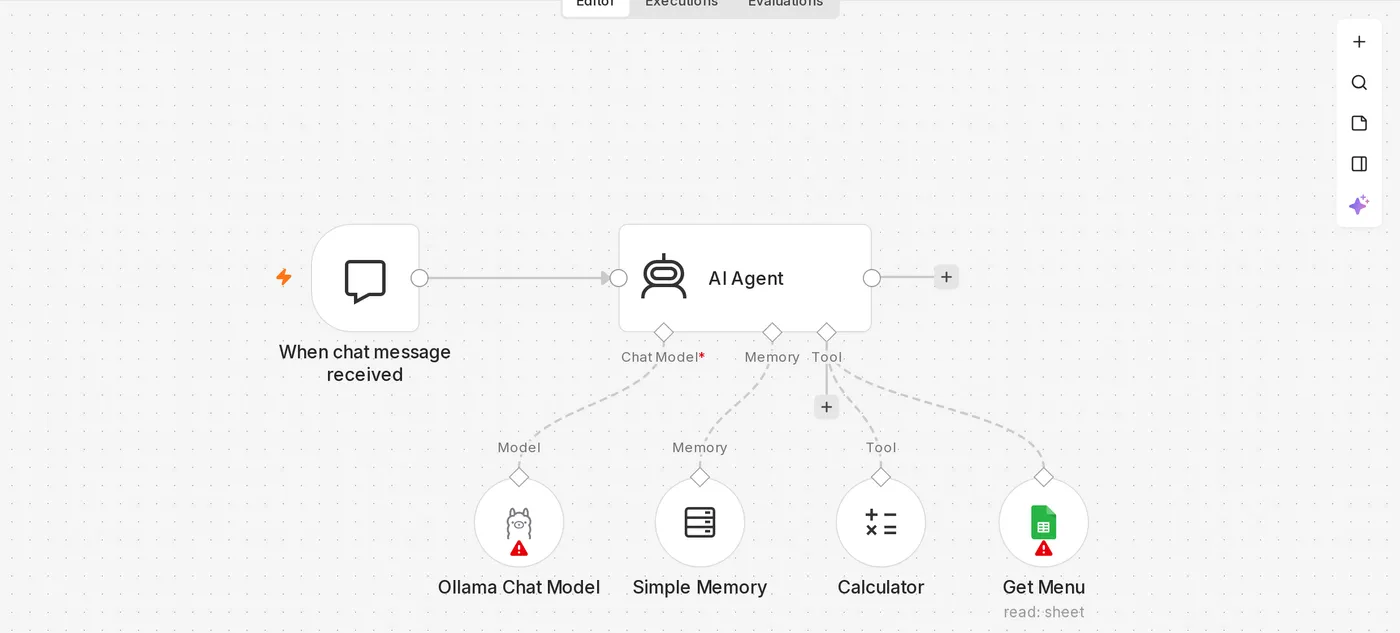
範例:本機 AI 客服信分類
[Gmail Trigger] ─▶ [Basic LLM Chain + Ollama Chat Model] ─▶ [Switch 依類別] ─▶ …不需要工具時,用 Basic LLM Chain 節點比 AI Agent 更簡單、更快。提示詞:
請把以下客戶來信分類為:詢價、訂單問題、客訴、其他。
只輸出類別名稱,不要輸出其他文字。

主旨:{{ $json.subject }}
內容:{{ $json.text }}
開啟 Require Specific Output Format 並接上 Structured Output Parser,可以讓模型輸出固定格式的 JSON,更方便後續節點使用。
模型參數
Ollama Chat Model 節點的 Options 中可以調整:
| 選項 | 說明 |
|---|---|
| Temperature | 分類、擷取資料時設為 0~0.3 |
| Context Length(num_ctx) | 處理長文件時調大 |
| Keep Alive | 模型在記憶體中保留多久,頻繁使用時調長 |
本機模型的注意事項
- 速度:取決於你的硬體。沒有顯示卡的伺服器上,8B 模型可能需要數十秒才能回答。
- 能力:小型本機模型在複雜的多工具 Agent 任務上,表現通常不如頂級雲端模型。單純的分類、摘要、翻譯、資料擷取效果較好。
- 工具呼叫:如果 Agent 不使用工具,試著換成更大或工具呼叫能力更好的模型,並簡化工具的數量。
常見錯誤
| 錯誤 | 原因 |
|---|---|
ECONNREFUSED 127.0.0.1:11434 | n8n 在 Docker 中卻填了 localhost,改用上表的網址 |
model "xxx" not found | Ollama 中還沒下載該模型,先執行 ollama pull |
| 請求逾時 | 模型太大、第一次載入太久,或只用 CPU 執行。換小一點的模型 |
| Agent 回覆 “does not support tools” | 選用的模型不支援工具呼叫 |
更新於 2026年10月12日