Conteúdo
Tutorial de n8n com Ollama: crie automações de IA com modelos locais gratuitos
Usar modelos na nuvem, como o OpenAI, custa de acordo com o uso, e os dados também são enviados para terceiros. Com o Ollama, você pode usar no n8n modelos de código aberto executados no seu computador ou servidor:
- Sem custos de API
- Os dados não saem do seu ambiente
- Ideal para processamentos repetitivos em grande volume (classificação, resumos, extração de dados)
Se ainda não conhece o Ollama, veja primeiro o tutorial do Ollama.
Prepare o Ollama e os modelos
ollama pull qwen3:8b        # modelo de chat, bom em chinês e compatível com chamadas de ferramentas
ollama pull bge-m3          # modelo de embeddings, para RAG
O AI Agent precisa de um modelo compatível com chamadas de ferramentas (indicado como tools em ollama.com).
A etapa mais importante: o endereço de conexão
O n8n precisa se conectar à API do Ollama (porta padrão 11434). O endereço depende de como os dois foram instalados:
| n8n | Ollama | Base URL |
|---|---|---|
| Instalação direta (npx) | Instalado diretamente no mesmo computador | http://localhost:11434 |
| Docker | Instalado diretamente no host (Windows / macOS) | http://host.docker.internal:11434 |
| Docker | Instalado diretamente no host (Linux) | http://host.docker.internal:11434, e adicione --add-host=host.docker.internal:host-gateway ao contêiner do n8n |
| Docker Compose | Serviço ollama no mesmo Compose | http://ollama:11434 |
| Qualquer configuração | Outro computador | http://IP-do-outro-computador:11434 |
Quando o n8n está em um contêiner Docker,
localhostaponta para o próprio contêiner, não para o seu computador. Essa é a causa mais comum de falhas de conexão.
O Ollama em um host Linux escuta por padrão apenas em 127.0.0.1, e talvez o contêiner Docker não consiga se conectar. Defina OLLAMA_HOST como 0.0.0.0 (e bloqueie conexões externas com o firewall). Veja como fazer em variáveis de ambiente do Ollama.
Recomendado: implante os dois com Compose
services:
  n8n:
    image: n8nio/n8n
    ports:
      - "5678:5678"
    environment:
      GENERIC_TIMEZONE: Asia/Taipei
      TZ: Asia/Taipei
    volumes:
      - n8n_data:/home/node/.n8n
    restart: unless-stopped

  ollama:
    image: ollama/ollama
    volumes:
      - ollama:/root/.ollama
    restart: unless-stopped
    # Adicione se tiver uma placa de vídeo NVIDIA:
    # deploy:
    #   resources:
    #     reservations:
    #       devices:
    #         - driver: nvidia
    #           count: all
    #           capabilities: [gpu]

volumes:
  n8n_data:
  ollama:
docker compose up -d
docker compose exec ollama ollama pull qwen3:8bNo n8n, informe http://ollama:11434 em Base URL.
Crie as credenciais do Ollama
- No campo Chat Model do AI Agent, selecione Ollama Chat Model.
- Crie uma nova credencial Ollama e preencha Base URL conforme a tabela acima.
- Ao salvar, o n8n testará a conexão. Se der certo, os modelos baixados aparecerão na lista suspensa Model.
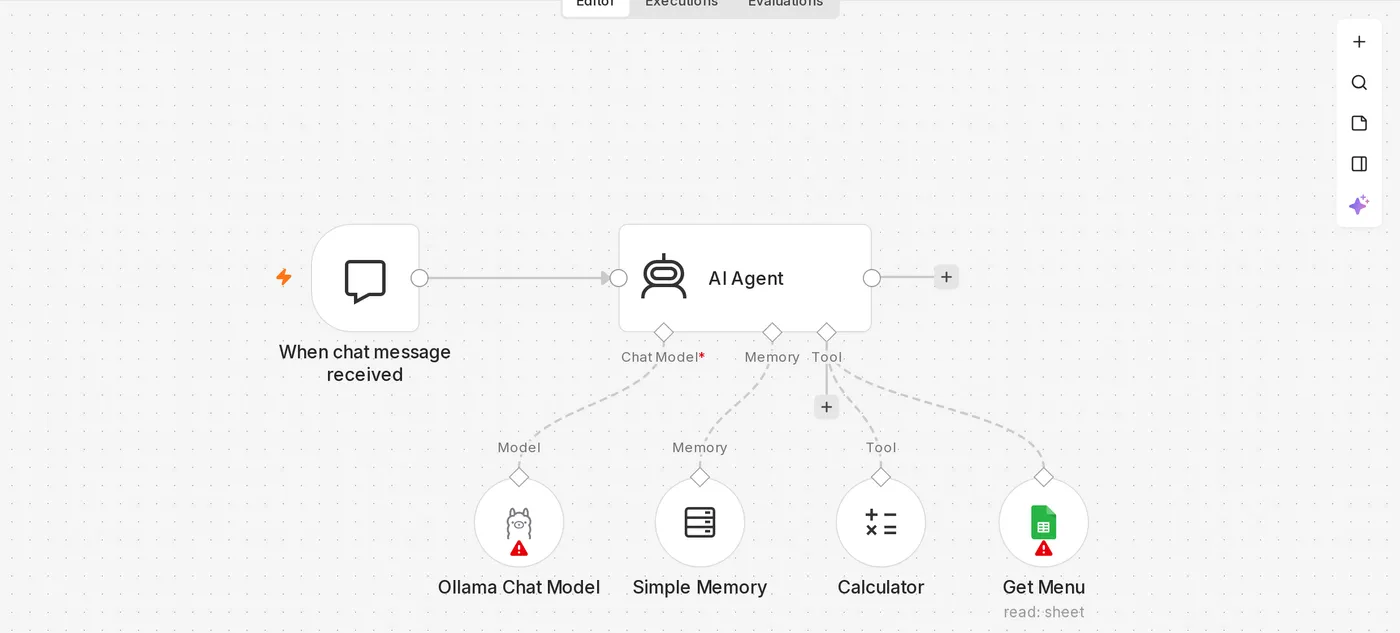
Exemplo: classifique e-mails de atendimento com IA local
[Gmail Trigger] ─▶ [Basic LLM Chain + Ollama Chat Model] ─▶ [Switch por categoria] ─▶ …Quando não precisar de ferramentas, o nó Basic LLM Chain é mais simples e rápido que o AI Agent. Use este prompt:
Classifique o e-mail do cliente abaixo como: consulta de preço, problema com pedido, reclamação ou outros.
Responda apenas com o nome da categoria, sem nenhum outro texto.

Assunto: {{ $json.subject }}
Conteúdo: {{ $json.text }}
Ative Require Specific Output Format e conecte um Structured Output Parser para que o modelo gere JSON em um formato fixo, facilitando o uso nos nós seguintes.
Parâmetros do modelo
Em Options no nó Ollama Chat Model, você pode ajustar:
| Opção | Descrição |
|---|---|
| Temperature | Defina entre 0 e 0.3 para classificação e extração de dados |
| Context Length (num_ctx) | Aumente ao processar documentos longos |
| Keep Alive | Define por quanto tempo o modelo fica na memória; aumente se usá-lo com frequência |
Cuidados ao usar modelos locais
- Velocidade: depende do seu hardware. Em um servidor sem placa de vídeo, um modelo 8B pode levar dezenas de segundos para responder.
- Capacidade: em tarefas complexas de Agent com várias ferramentas, modelos locais pequenos costumam ter desempenho inferior ao de modelos de ponta na nuvem. Eles funcionam melhor para tarefas simples de classificação, resumo, tradução e extração de dados.
- Chamadas de ferramentas: se o Agent não usar as ferramentas, experimente um modelo maior ou com melhor suporte a chamadas de ferramentas e simplifique a quantidade de ferramentas.
Erros comuns
| Erro | Causa |
|---|---|
ECONNREFUSED 127.0.0.1:11434 | O n8n está no Docker, mas foi configurado com localhost. Use o endereço da tabela acima |
model "xxx" not found | O modelo ainda não foi baixado no Ollama. Execute ollama pull primeiro |
| Tempo limite da solicitação | O modelo é grande demais, demora para carregar na primeira vez ou está sendo executado apenas na CPU. Tente um modelo menor |
| Agent responde "does not support tools" | O modelo selecionado não é compatível com chamadas de ferramentas |
Atualizado 12 de outubro de 2026