目录
n8n Ollama 教程:使用本地免费模型构建 AI 自动化
使用 OpenAI 等云端模型需要按用量付费,数据也会传到外部。搭配 Ollama,可以让 n8n 使用在自己的电脑或服务器上运行的开源模型:
- 无需 API 费用
- 数据完全不会离开你的环境
- 适合大量、重复的处理(分类、摘要、提取数据)
如果还不熟悉 Ollama,可以先看 Ollama 教程。
准备 Ollama 和模型
ollama pull qwen3:8b        # 聊天模型,中文能力好,支持工具调用
ollama pull bge-m3          # 嵌入模型,用于 RAG
AI Agent 需要支持工具调用的模型(在 ollama.com 上标注为 tools)。
最重要的一步:连接地址
n8n 需要能够连接到 Ollama 的 API(默认端口 11434)。地址取决于两者的安装方式:
| n8n | Ollama | Base URL |
|---|---|---|
| 直接安装(npx) | 在同一台电脑上直接安装 | http://localhost:11434 |
| Docker | 直接安装在主机上(Windows / macOS) | http://host.docker.internal:11434 |
| Docker | 直接安装在主机上(Linux) | http://host.docker.internal:11434,并在 n8n 容器中添加 --add-host=host.docker.internal:host-gateway |
| Docker Compose | 同一个 Compose 中的 ollama 服务 | http://ollama:11434 |
| 任意 | 另一台电脑 | http://那台电脑的IP:11434 |
n8n 在 Docker 容器中运行时,
localhost指的是容器本身,而不是你的电脑。这是最常见的连接失败原因。
Linux 主机上的 Ollama 默认只监听 127.0.0.1,Docker 容器可能无法连接。需要将 OLLAMA_HOST 设为 0.0.0.0(并通过防火墙阻止外部连接),设置方法见 Ollama 环境变量。
推荐:使用 Compose 一起部署
services:
  n8n:
    image: n8nio/n8n
    ports:
      - "5678:5678"
    environment:
      GENERIC_TIMEZONE: Asia/Taipei
      TZ: Asia/Taipei
    volumes:
      - n8n_data:/home/node/.n8n
    restart: unless-stopped

  ollama:
    image: ollama/ollama
    volumes:
      - ollama:/root/.ollama
    restart: unless-stopped
    # 如果有 NVIDIA 显卡,请添加:
    # deploy:
    #   resources:
    #     reservations:
    #       devices:
    #         - driver: nvidia
    #           count: all
    #           capabilities: [gpu]

volumes:
  n8n_data:
  ollama:
docker compose up -d
docker compose exec ollama ollama pull qwen3:8b在 n8n 中将 Base URL 填为 http://ollama:11434。
创建 Ollama 凭证
- 在 AI Agent 的 Chat Model 插槽中选择 Ollama Chat Model。
- 创建新的 Ollama 凭证,Base URL 按上表填写。
- 保存时,n8n 会测试连接。连接成功后,可以在 Model 下拉菜单中看到已下载的模型。
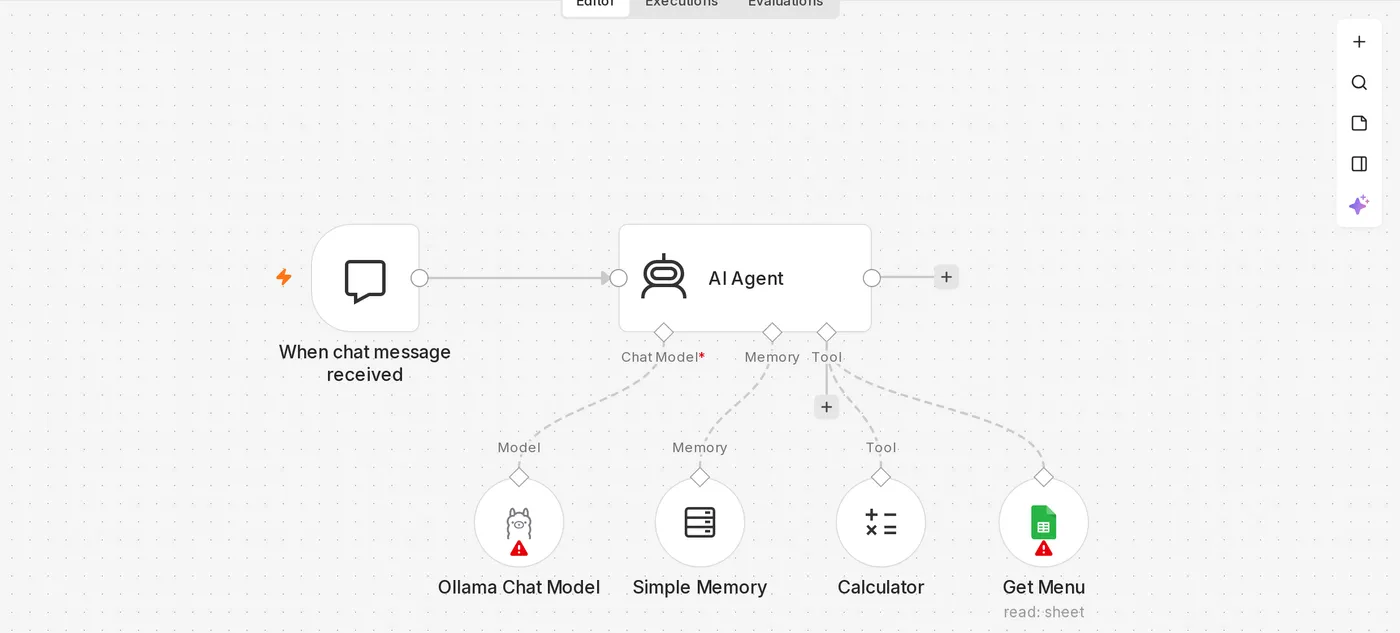
示例:使用本地 AI 对客服邮件分类
[Gmail Trigger] ─▶ [Basic LLM Chain + Ollama Chat Model] ─▶ [Switch 依类别] ─▶ …不需要工具时,使用 Basic LLM Chain 节点比 AI Agent 更简单、更快。提示词:
请将以下客户来信分类为:询价、订单问题、投诉、其他。
只输出类别名称,不要输出其他文字。

主题:{{ $json.subject }}
内容:{{ $json.text }}
启用 Require Specific Output Format 并连接 Structured Output Parser,可以让模型输出固定格式的 JSON,方便后续节点使用。
模型参数
可以在 Ollama Chat Model 节点的 Options 中调整:
| 选项 | 说明 |
|---|---|
| Temperature | 分类、提取数据时设为 0~0.3 |
| Context Length(num_ctx) | 处理长文档时调大 |
| Keep Alive | 模型在内存中保留的时长,频繁使用时调长 |
使用本地模型的注意事项
- 速度:取决于你的硬件。在没有显卡的服务器上,8B 模型可能需要几十秒才能回答。
- 能力:小型本地模型执行复杂的多工具 Agent 任务时,表现通常不如顶级云端模型。用于简单的分类、摘要、翻译、数据提取时效果更好。
- 工具调用:如果 Agent 不使用工具,可以尝试换成更大或工具调用能力更强的模型,并简化工具数量。
常见错误
| 错误 | 原因 |
|---|---|
ECONNREFUSED 127.0.0.1:11434 | n8n 在 Docker 中运行却填写了 localhost,请改用上表中的地址 |
model "xxx" not found | Ollama 中尚未下载该模型,请先运行 ollama pull |
| 请求超时 | 模型太大、首次加载耗时太长,或只使用 CPU 运行。请换用较小的模型 |
| Agent 回复 "does not support tools" | 所选模型不支持工具调用 |
更新于 2026年10月12日