Contenido
Tutorial de Flux y modelos de imagen de nueva generación en ComfyUI
Después de SD 1.5 y SDXL, los modelos de imagen de código abierto de nueva generación, como la serie Flux de Black Forest Labs, la serie Qwen-Image de Alibaba y otros modelos que siguen apareciendo, han mejorado notablemente la calidad visual, la comprensión de las indicaciones y la representación de texto. ComfyUI suele ofrecer compatibilidad poco después del lanzamiento de un modelo.
Diferencias principales con SDXL
| SD 1.5 / SDXL | Modelos de nueva generación (Flux, Qwen-Image, etc.) | |
|---|---|---|
| Tamaño del modelo | 2~7 GB | A menudo, 10~20 GB o más (también hay versiones comprimidas) |
| Archivos del modelo | Un checkpoint | El modelo de difusión, el codificador de texto y el VAE suelen estar separados |
| Indicaciones | Principalmente palabras clave | Entienden frases completas y pueden dibujar el texto indicado |
| Indicaciones negativas | Eficaces | Muchos modelos no las usan (CFG es 1) |
| Memoria de GPU | Se puede usar con 6~8 GB | Se recomiendan 12 GB o más, o una versión cuantizada |
La forma más sencilla de empezar: plantillas oficiales
Cada modelo nuevo tiene una combinación de nodos y parámetros distinta. La forma más fiable es usar las plantillas integradas de ComfyUI:
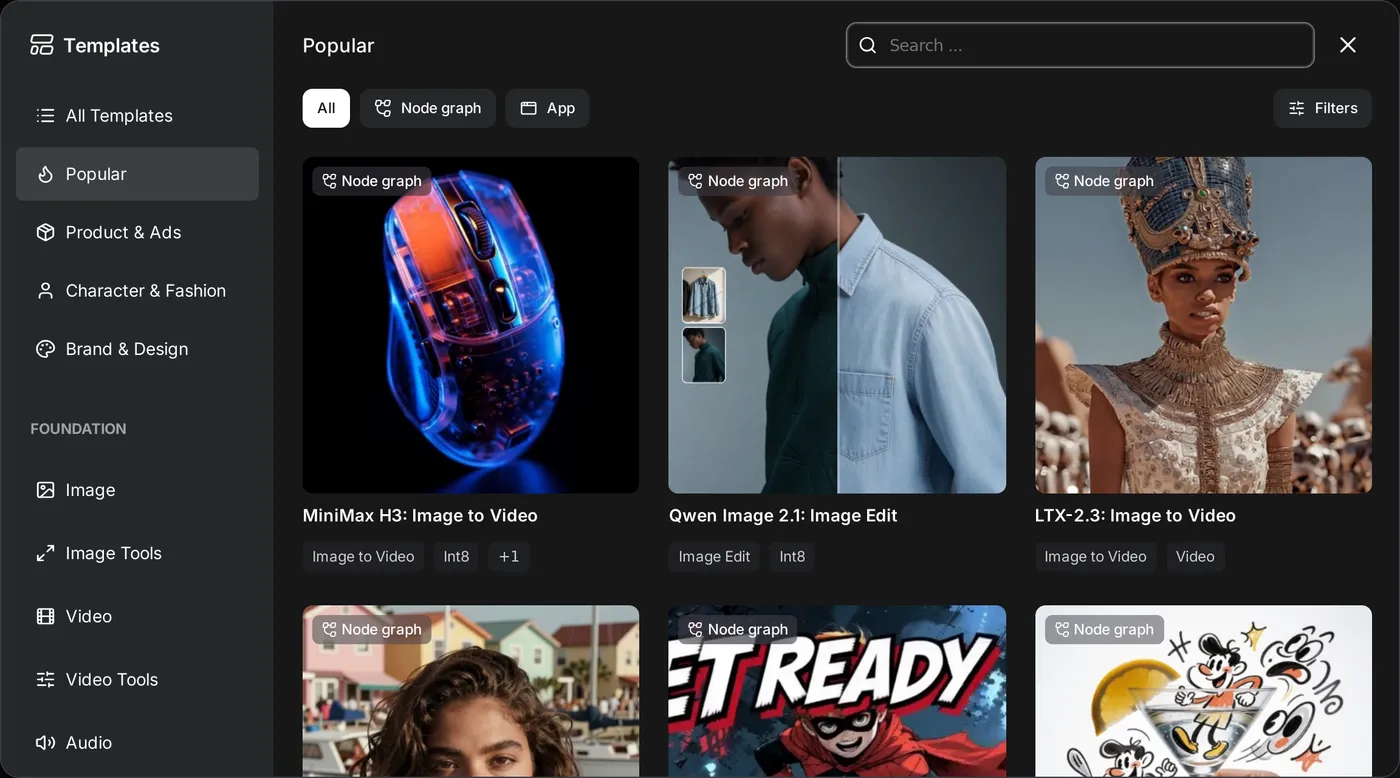
- Menú → Browse Templates.
- Busca la categoría del modelo que quieras usar, como Flux o Qwen-Image, y elige una plantilla de texto a imagen.
- Después de cargarla, si faltan modelos, ComfyUI suele mostrar la lista de archivos que debes descargar y los enlaces correspondientes; incluso puede descargarlos directamente en la carpeta correcta.
- Comprueba que cada nodo de carga tenga seleccionado el archivo correcto y pulsa Run.
Los parámetros de la plantilla (pasos, sampler y guidance) son los ajustes recomendados oficialmente. Primero genera imágenes con ellos y, cuando te familiarices, ajústalos.
Dónde colocar los archivos
Los archivos de modelos separados suelen colocarse así:
models/
├── diffusion_models/   modelo principal de flux o qwen-image
├── text_encoders/      codificadores de texto (por ejemplo, clip_l, t5xxl, qwen, según el modelo)
└── vae/                VAE específico del modelo
Nodos correspondientes:
| Archivo | Nodo |
|---|---|
| Modelo principal | Load Diffusion Model (UNETLoader) |
| Codificador de texto | Load CLIP, DualCLIPLoader, etc.; elige el modelo correspondiente en type |
| VAE | Load VAE |
Cada modelo usa distintos codificadores de texto y VAE. No los mezcles. Descárgalos siguiendo las instrucciones de la plantilla o de la página del modelo.
Si no tienes suficiente memoria de GPU
| Versión | Descripción |
|---|---|
| FP8 | El archivo ocupa aproximadamente la mitad que el original, con poca pérdida de calidad. También puedes elegir fp8 en weight_dtype de Load Diffusion Model |
| GGUF cuantizado (Q8, Q6, Q5, Q4…) | Es más pequeño; requiere el nodo personalizado ComfyUI-GGUF. Sustituye Load Diffusion Model / Load CLIP por sus nodos de carga |
| Versión destilada / acelerada | Necesita menos pasos (por ejemplo, 4~8), por lo que es mucho más rápida |
ComfyUI mueve automáticamente a la memoria del sistema las partes que no caben en la GPU (lo que reduce la velocidad). Por eso, normalmente puede ejecutarse incluso si falta algo de memoria de GPU, aunque irá más lento. Se recomiendan al menos 32 GB de memoria del sistema.
Cómo escribir indicaciones
Los modelos de nueva generación entienden el lenguaje natural. Describe la imagen con frases completas:
A cozy bookstore in an old Taipei alley at dusk. A hand-painted wooden sign above the
door says "Corner Books" in neat white letters. Warm light spills onto the wet street,
and a black cat sits by the doorway. Shot on a 35mm film camera.- Si quieres que aparezca texto en la imagen, ponlo entre comillas.
- Describir la composición, la iluminación y el objetivo es más eficaz que acumular palabras como «masterpiece, best quality».
- Algunos modelos, como Qwen-Image, también admiten bien las indicaciones en chino y la representación de caracteres chinos.
Modelos de edición de imágenes
Además de generar imágenes a partir de texto, los modelos de nueva generación también incluyen modelos de edición específicos, como Flux Kontext y Qwen-Image-Edit. Introduce una imagen y una instrucción, por ejemplo:
Cambia el fondo por una calle nevada y mantén igual a la personaPuedes cambiar el fondo, modificar el color de la ropa, quitar objetos o editar el texto de una imagen sin dibujar una máscara a mano. Busca Edit o Kontext en las plantillas para encontrar el flujo de trabajo correspondiente.
LoRA y ControlNet
Los modelos nuevos también tienen sus propias versiones de LoRA y ControlNet, pero deben haberse entrenado para ese modelo. No puedes usar una LoRA de SDXL con Flux. Para cargar LoRA con un modelo nuevo, normalmente se usa el nodo LoraLoaderModelOnly.
Licencias
Las licencias de los modelos de nueva generación varían mucho: algunos permiten el uso comercial, otros solo el uso no comercial (por ejemplo, algunas versiones de Flux) y otros requieren obtener una licencia adicional. Antes de usar un modelo con fines comerciales, comprueba siempre sus condiciones de licencia.
Actualizado 12 de octubre de 2026