目次
ComfyUIでFluxなどの次世代画像モデルを使う方法:Flux、Qwen-Imageの導入
SD 1.5やSDXL以降、Black Forest LabsのFluxシリーズ、AlibabaのQwen-Imageシリーズなど、新世代のオープンソース画像モデルが登場し、画質、プロンプトの理解、文字の描画が大きく進歩しました。ComfyUIは通常、モデルの公開後すぐに対応します。
SDXLとの主な違い
| SD 1.5 / SDXL | 新世代モデル(Flux、Qwen-Imageなど) | |
|---|---|---|
| モデルサイズ | 2~7 GB | 多くは10~20 GB以上(圧縮版もあります) |
| モデルファイル | 1つのcheckpoint | 拡散モデル、テキストエンコーダー、VAEが別々の場合が多い |
| プロンプト | キーワードが中心 | 文章全体を理解し、指定した文字を描画できます |
| ネガティブプロンプト | 有効 | 多くのモデルでは使用しません(CFGは1) |
| VRAM | 6~8 GBで使用可能 | 12 GB以上を推奨。量子化版も利用できます |
まずは公式テンプレートから
新しいモデルはノードの構成やパラメーターがそれぞれ異なります。最も確実なのはComfyUI内蔵のテンプレートを使うことです。
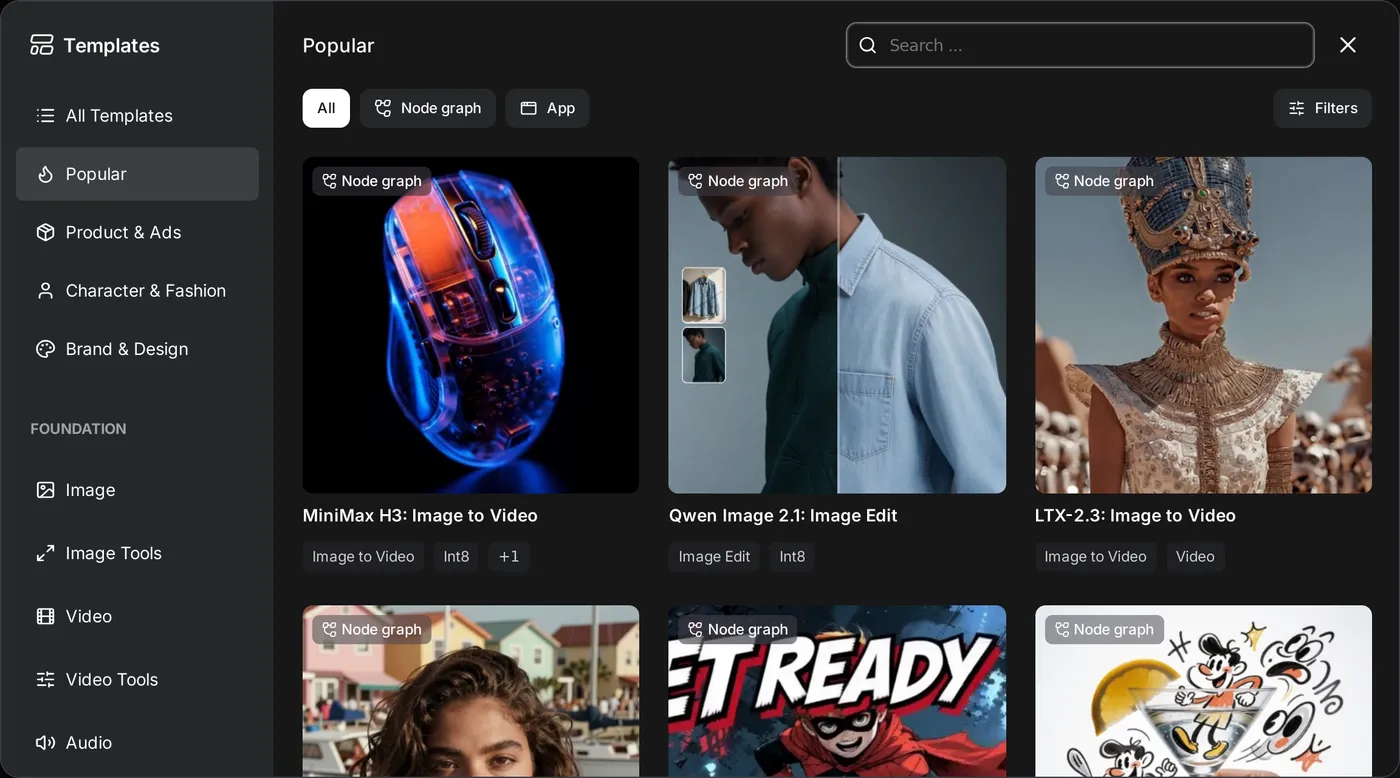
- メニューからBrowse Templatesを選択します。
- FluxやQwen-Imageなど、使いたいモデルのカテゴリを探し、文から画像を生成するテンプレートを選びます。
- 読み込み後、モデルが不足している場合、ComfyUIは通常、必要なファイルの一覧とダウンロードリンクを表示します。正しいフォルダーに直接ダウンロードできる場合もあります。
- 各ローダーノードで正しいファイルが選択されていることを確認し、Runを押します。
テンプレートのパラメーター(steps、sampler、guidance)は公式の推奨設定です。まずはその設定で生成し、慣れてから調整してください。
ファイルの配置方法
分割されたモデルファイルは、通常次のように配置します。
models/
├── diffusion_models/   FluxやQwen-Imageのメインモデル
├── text_encoders/      テキストエンコーダー(例:clip_l、t5xxl、qwenなど。モデルによって異なります)
└── vae/                モデル専用のVAE
対応するノードは次のとおりです。
| ファイル | ノード |
|---|---|
| メインモデル | Load Diffusion Model(UNETLoader) |
| テキストエンコーダー | Load CLIP、DualCLIPLoaderなど。typeで対応するモデルを選択 |
| VAE | Load VAE |
モデルごとに使うテキストエンコーダーとVAEは異なります。**互換性のないものは組み合わせないでください。**テンプレートまたはモデルのページの説明に従ってダウンロードします。
VRAMが足りない場合
| バージョン | 説明 |
|---|---|
| FP8 | ファイルサイズは元の約半分で、画質の低下もわずかです。Load Diffusion Modelのweight_dtypeでfp8を選ぶこともできます |
| GGUF量子化版(Q8、Q6、Q5、Q4…) | さらに小さくなります。カスタムノードのComfyUI-GGUFが必要です。Load Diffusion Model/Load CLIPの代わりに、そのノードのローダーを使います |
| 蒸留版/高速化版 | ステップ数が少なく(例:4~8ステップ)、大幅に速くなります |
ComfyUIは、VRAMに収まらない部分を自動的にシステムメモリへ移します(速度は遅くなります)。そのため、VRAMが少し不足していても、通常は実行できますが、時間がかかります。システムメモリは32 GB以上を推奨します。
プロンプトの書き方
新世代モデルは自然言語を理解するため、画面を文章で詳しく説明します。
A cozy bookstore in an old Taipei alley at dusk. A hand-painted wooden sign above the
door says "Corner Books" in neat white letters. Warm light spills onto the wet street,
and a black cat sits by the doorway. Shot on a 35mm film camera.- 画像内に文字を表示したい場合は、その文字を引用符で囲みます。
- 「masterpiece, best quality」のような語句を並べるより、構図、光、レンズを説明する方が効果的です。
- Qwen-Imageなど一部のモデルは、中国語のプロンプトや中国語の文字の描画にもよく対応しています。
画像編集モデル
テキストから画像を生成するモデルのほか、新世代モデルには編集モデル(Flux Kontext、Qwen-Image-Editなど)もあります。画像を1枚入力し、次のような指示を与えます。
背景を雪の降る通りに変え、人物はそのままにしてくださいマスクを手作業で描かなくても、背景の変更、服の色の変更、物の削除、画像内の文字の修正ができます。テンプレートでEditまたはKontextを検索すると、対応するワークフローが見つかります。
LoRAとControlNet
新しいモデルにも対応するLoRAやControlNetがありますが、**そのモデル向けに学習されたバージョンを使う必要があります。**SDXL用のLoRAはFluxでは使えません。新しいモデルのLoRAを読み込むときは、通常、LoraLoaderModelOnlyノードを使います。
ライセンス
新世代モデルのライセンスはさまざまです。商用利用できるもの、非商用利用に限られるもの(Fluxの一部のバージョンなど)、追加のライセンス取得が必要なものがあります。商用利用の前に、必ずモデルのライセンス条項を確認してください。
更新日 2026年10月12日