Conteúdo
Como usar Flux, Qwen-Image e outros modelos de nova geração no ComfyUI
Depois do SD 1.5 e do SDXL, os novos modelos de imagem de código aberto (como a série Flux, da Black Forest Labs, a série Qwen-Image, do Alibaba, e outros lançados continuamente) apresentam avanços significativos na qualidade das imagens, na compreensão de prompts e na geração de texto. O ComfyUI costuma oferecer suporte pouco depois do lançamento dos modelos.
Principais diferenças em relação ao SDXL
| SD 1.5 / SDXL | Modelos de nova geração (Flux, Qwen-Image etc.) | |
|---|---|---|
| Tamanho do modelo | 2 a 7 GB | Geralmente 10 a 20 GB ou mais (também há versões compactadas) |
| Arquivos do modelo | Um checkpoint | Modelo de difusão, codificador de texto e VAE costumam ficar separados |
| Prompt | Principalmente palavras-chave | Entendem frases completas e conseguem desenhar o texto especificado |
| Prompt negativo | Eficaz | Muitos modelos não usam (CFG igual a 1) |
| VRAM | 6 a 8 GB são suficientes | Recomendável ter 12 GB ou mais, ou usar uma versão quantizada |
A forma mais simples de começar: modelos oficiais
As combinações de nós e os parâmetros variam entre os novos modelos. A forma mais confiável é usar os modelos incluídos no ComfyUI:
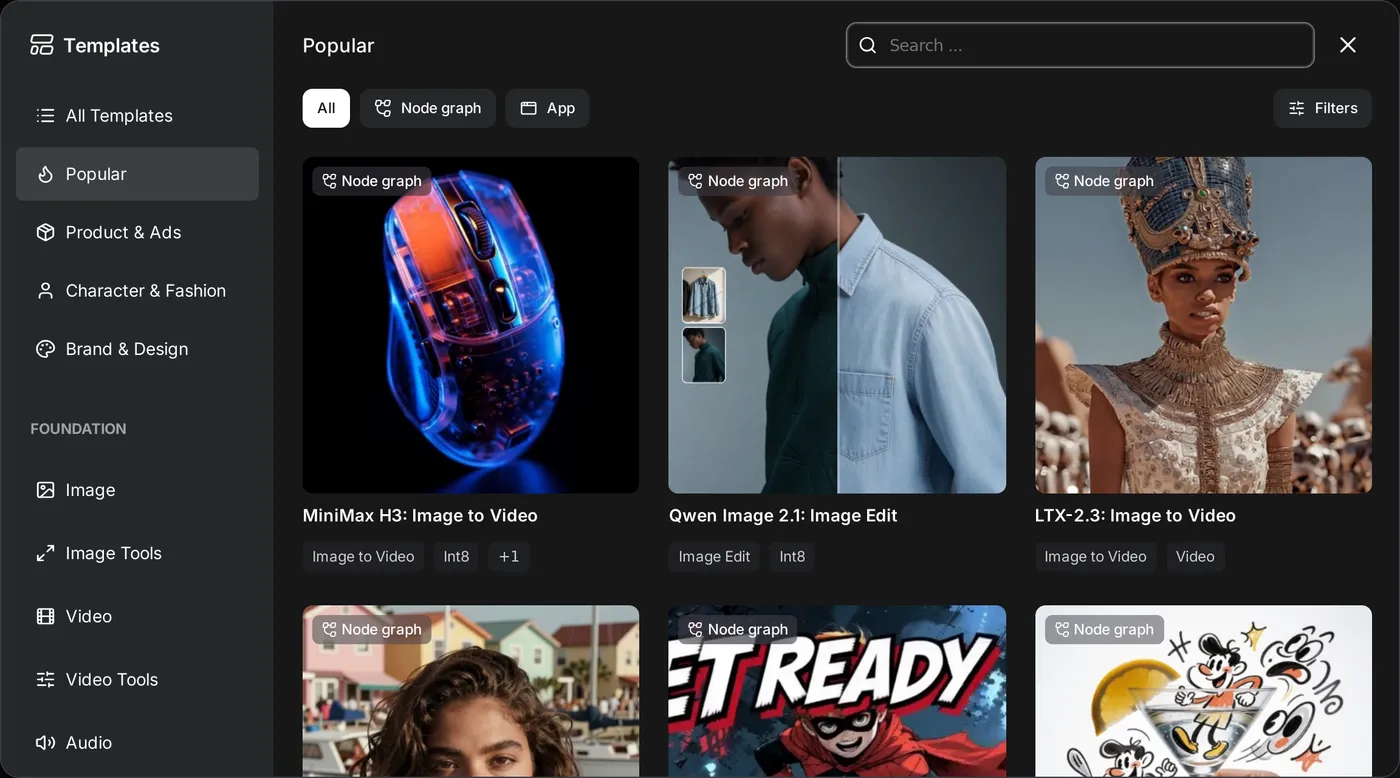
- Menu → Browse Templates.
- Encontre a categoria do modelo que você quer usar, como Flux ou Qwen-Image, e selecione um modelo de texto para imagem.
- Depois de carregar o modelo, se algum arquivo estiver faltando, o ComfyUI geralmente mostra uma lista dos arquivos que precisam ser baixados e os links para baixá-los. Em alguns casos, você pode baixá-los diretamente para a pasta correta.
- Confira se cada nó de carregamento selecionou o arquivo correto e clique em Run.
Os parâmetros do modelo (etapas, sampler e guidance) são as configurações recomendadas oficialmente. Gere imagens com esses valores primeiro e ajuste-os depois que estiver familiarizado com o processo.
Como organizar os arquivos
Os arquivos de modelos separados costumam ser organizados assim:
models/
├── diffusion_models/   modelo principal de flux ou qwen-image
├── text_encoders/      codificadores de texto (como clip_l, t5xxl ou qwen, dependendo do modelo)
└── vae/                VAE específico do modelo
Nós correspondentes:
| Arquivo | Nó |
|---|---|
| Modelo principal | Load Diffusion Model (UNETLoader) |
| Codificador de texto | Load CLIP, DualCLIPLoader etc.; escolha o modelo correspondente em type |
| VAE | Load VAE |
Cada modelo usa codificadores de texto e VAE diferentes. Você não pode misturá-los. Baixe os arquivos de acordo com as instruções do modelo ou do modelo de fluxo de trabalho.
Se faltar VRAM
| Versão | Descrição |
|---|---|
| FP8 | O arquivo tem aproximadamente metade do tamanho original, com pouca perda de qualidade. Você também pode selecionar fp8 em weight_dtype de Load Diffusion Model |
| Quantização GGUF (Q8, Q6, Q5, Q4…) | Ocupa menos espaço e requer o nó personalizado ComfyUI-GGUF. Substitua Load Diffusion Model / Load CLIP pelos nós de carregamento dele |
| Versão destilada / acelerada | Usa menos etapas (por exemplo, 4 a 8) e é muito mais rápida |
O ComfyUI transfere automaticamente para a memória do sistema as partes que não cabem na VRAM (o que reduz a velocidade). Por isso, geralmente ainda é possível executar o modelo mesmo quando falta um pouco de VRAM, mas o processo fica mais lento. Recomendamos pelo menos 32 GB de memória do sistema.
Como escrever prompts
Os modelos de nova geração entendem linguagem natural. Descreva a imagem com frases completas:
A cozy bookstore in an old Taipei alley at dusk. A hand-painted wooden sign above the
door says "Corner Books" in neat white letters. Warm light spills onto the wet street,
and a black cat sits by the doorway. Shot on a 35mm film camera.- Para incluir texto na imagem, coloque-o entre aspas.
- Descrever a composição, a iluminação e a câmera funciona melhor do que acumular termos como "masterpiece, best quality".
- Alguns modelos, como Qwen-Image, também oferecem bom suporte a prompts em chinês e à geração de caracteres chineses.
Modelos de edição de imagem
Além da geração de texto para imagem, há também modelos de edição específicos de nova geração, como Flux Kontext e Qwen-Image-Edit. Você fornece uma imagem e uma instrução, por exemplo:
Troque o fundo por uma rua com neve e mantenha a pessoa como está.Você pode trocar o fundo, mudar a cor das roupas, remover objetos e editar o texto na imagem sem desenhar máscaras manualmente. Pesquise por Edit ou Kontext nos modelos para encontrar o fluxo de trabalho correspondente.
LoRA e ControlNet
Também existem LoRAs e ControlNets para os novos modelos, mas eles precisam ter sido treinados para o modelo correspondente. Você não pode usar LoRAs de SDXL com Flux. Para carregar uma LoRA em um modelo novo, geralmente se usa o nó LoraLoaderModelOnly.
Licenças
As licenças dos modelos de nova geração variam bastante: alguns permitem uso comercial, outros são apenas para uso não comercial (como algumas versões do Flux) e outros exigem a obtenção de uma licença adicional. Antes de usar um modelo comercialmente, confira os termos da licença.
Atualizado 12 de outubro de 2026